|
СПЕЦІАЛЬНІ
ПАРТНЕРИ
ПРОЕКТУ
Определение наиболее профессиональных ИТ-управленцев, лидеров и экспертов в своих отраслях
Кто внес наибольший вклад в развитие украинского ИТ-рынка.
Награды «Продукт года» еженедельника «Компьютерное обозрение» за наиболее выдающиеся ИТ-товары
|
|

3 ноября 2026 г., 17:25
У другому та третьому кварталах APT-групи посилили атаки на українські державні, військові та промислові структури. Зокрема Eset зафіксувала першу руйнівну кібератаку білоруського угруповання в Європі, кампанію проти поштових серверів MDaemon і нові способи використання AI кіберзлочинцями.

У звіті за квітень-вересень 2026 року дослідники компанії Eset зафіксували зміни в діяльності державних хакерських угруповань. Російські операції залишаються зосередженими на Україні, білоруські групи дедалі частіше діють відповідно до інтересів москви, а північнокорейські оператори розширюють атаки на ланцюги постачання програмного забезпечення.
Україна залишається головною ціллю російських APT-груп у Європі. У другому та третьому кварталах під атаками були державні установи, органи місцевого самоврядування, медичні заклади, військові, оборонні підприємства та організації, пов'язані з інфраструктурою. Серед найбільш активних угруповань Eset називає Gamaredon, Sednit і TA488.
Водночас дослідники фіксують посилення координації між російськими та білоруськими хакерськими групами. Йдеться не лише про схожі цілі, а й про збіг оперативних завдань та інструментів. За оцінкою фахівців, білоруські угруповання можуть поступово переходити до тіснішої співпраці з російськими силовими структурами.
Найпоказовіший епізод стався наприкінці травня. Група FrostyNeighbor атакувала українське виробниче підприємство, пов'язане з транспортним сектором. Після отримання доступу зловмисники використали Chisel, UltraVNC і Cobalt Strike, а завершальним етапом стало розгортання скрипту-вайпера через Group Policy. Такий інструмент призначений для знищення даних.
Eset називає цей випадок першою задокументованою руйнівною кібератакою білоруського APT-угруповання в європейському регіоні. Дослідники не стверджують, що операцію безпосередньо координувала москва, однак її цілі більше відповідають російським військовим пріоритетам, ніж самостійним інтересам мінська. Це створює ризик подальшого поширення руйнівних операцій на інші білоруські групи.
Інший показовий випадок стосується поштової інфраструктури. Фахівці дослідили кампанію проти українських організацій, у якій зловмисники експлуатували вразливість у MDaemon Mail Server. Атака не потребувала жодних дій від користувача: достатньо було надіслати спеціально сформований RAR-архів на будь-яку адресу вразливого поштового сервера.
Причиною стала застаріла бібліотека libclamunrar.dll, яку MDaemon використовував для перевірки вкладень через ClamAV. Вона містила вразливість CVE-2025-8088, пов'язану з обходом каталогів у WinRAR. Попри те, що виправлення для ClamAV з'явилося ще 27 липня 2025 року, MDaemon продовжував постачати стару версію бібліотеки.
У результаті обробка вкладення могла призвести до виконання коду на сервері та запису шкідливої DLL у файлову систему. Для закріплення в системах зловмисники використовували два бекдори, Hellage і Helltag. Перший викрадав електронну пошту та інші дані й міг завантажувати додаткове шкідливе ПЗ. Другий забезпечував віддалене виконання команд, передавання файлів і збір інформації про систему через Telegram-бота.
MDaemon усунув проблему у версії 26.0.4 від 25 серпня 2026 року. Цей випадок показує ризик залежності захисних механізмів від сторонніх компонентів: оновлення основного продукту не завжди означає, що всі його бібліотеки також актуальні.
Зміни відбуваються і в діяльності північнокорейських груп. Lazarus відновила операцію DreamJob, спрямовану на виробників безпілотників та суміжні ланцюги постачання. Кампанія активізувалася орієнтовно в червні. Зловмисники використовували фальшиві вакансії та пропозиції роботи, щоб зацікавити співробітників оборонних компаній. Серед цілей були європейські підприємства, які виробляють безпілотні системи або займають важливі позиції в їхньому ланцюгу постачання.

Паралельно інше північнокорейське угруповання, DeceptiveDevelopment, змістило фокус із компрометації окремих розробників на ланцюг постачання програмного забезпечення. Після зараження комп'ютера розробника зловмисники викрадали Git-облікові дані, SSH-ключі та токени доступу. Отримані облікові дані дозволяли змінювати код у репозиторіях і приховувати втручання через переписування історії комітів.
Скомпрометовані компоненти поширювалися через npm, PyPI, Packagist, дзеркало Go-модулів і магазини розширень браузерів. Більшість постраждалих проєктів були невеликими утилітами, які підтримували окремі розробники. Це вказує на автоматизоване поширення: кожен заражений проєкт ставав потенційною точкою входу для його користувачів.
Для компаній, які активно використовують open-source залежності, така модель загрожує виходом атаки за межі початкової організації. Компрометація облікового запису одного розробника може вплинути на репозиторії, програмні компоненти та продукти, які використовують інші команди. Контроль доступу до систем керування кодом, захист токенів і перевірка змін у залежностях стають частиною захисту корпоративної інфраструктури.
Окремо Eset оцінює використання штучного інтелекту в операціях APT-груп. Дослідники виявили випадки застосування великих мовних моделей для прискорення розробки шкідливого ПЗ, створення фальшивих сайтів і підготовки фішингових матеріалів. В одному з епізодів російське угруповання UAC-0099 додало в коментар до скрипту фальшивий запит щодо створення ядерної зброї. Ймовірною метою було спровокувати захисні механізми LLM-систем аналізу коду та перешкодити перевірці шкідливого вмісту.
Попри ці приклади, Eset не бачить ознак того, що AI вже докорінно змінив характер APT-операцій. Більшість досліджених атак залишаються керованими людьми. Моделі використовують переважно як засіб прискорення окремих завдань, а не для повністю автономного проведення атак.
Загальна картина звіту вказує на кілька паралельних тенденцій: зближення російських і білоруських кібероперацій, зростання ризику руйнівних атак, використання вразливостей у корпоративному програмному забезпеченні та перенесення атак на ланцюги постачання.
22 октября 2026 г., 17:25
Торік двадцять українських компаній із КВЕД «Видання комп’ютерних ігор» отримали понад 2,6 млрд грн доходу. Проте рейтинг не охоплює значну частину індустрії, зокрема розробників відомих ігор, зареєстрованих за іншими видами діяльності, йдеться у дослідженні YC.Market.
Український геймдев працює одночасно на двох ринках. Один формують студії, які розробляють власні ігри та заробляють на інтелектуальній власності. Другий становлять сервісні компанії, залучені до створення, тестування, художнього оформлення та портування міжнародних проєктів. За даними дослідження YC.Market, у 2025 році сукупний дохід двадцяти українських компаній з основним КВЕД 58.21 «Видання комп’ютерних ігор» перевищив 2,6 млрд грн. Однак ці цифри описують лише частину індустрії.
До рейтингу потрапили лише юридичні особи, для яких видання комп’ютерних ігор є основним видом діяльності. Компанії, що працюють за КВЕД 62.01 «Комп’ютерне програмування», залишилися поза ним, навіть якщо створюють відомі ігрові продукти.
Наприклад найбільший дохід серед компаній із відповідним КВЕД у 2025 році показало ТОВ «Гейм Реселлер». Водночас за даними YC.Market, у відкритих реєстрах за цією юридичною особою не виявлено зареєстрованих прав на інтелектуальну власність виданих ігор, а саму компанію не знайдено серед представлених видавців на Steam, App Store та Google Play. Вона також має ліцензію на діяльність у сфері азартних ігор. Ці обставини не дають підстав автоматично ототожнювати її дохід із виручкою від розробки чи продажу власних ігор.
Серед інших лідерів є компанії з виразнішим зв’язком із виробництвом ігрового контенту. 4A Games, відома серією Metro, розвиває власну франшизу. Ulysses Graphics працює над графікою та 3D-асетами для міжнародних проєктів, зокрема Borderlands 4 і Hunt: Showdown 1896, а паралельно розвиває власну гру Project Hover. Така комбінація сервісної роботи й власних продуктів дає змогу поєднувати доходи від контрактів із потенційним заробітком на інтелектуальній власності.
Сервісна модель залишається важливою частиною української присутності на глобальному ринку. Room 8 Group, Volmi Games, N-iX Games та Ulysses Graphics залучені до виробничих процесів міжнародних ігрових компаній. Українські фахівці працювали над проєктами Call of Duty: Modern Warfare III, Dead Space Remake, Alan Wake II та Diablo IV. Їхня роль охоплює різні етапи розробки, від створення графіки до тестування та адаптації ігор для різних платформ.
Таким чином експортна спеціалізація не обмежується створенням завершених продуктів. Українські команди також постачають міжнародним видавцям окремі виробничі компетенції. Водночас робота над відомою грою не означає, що компанія володіє її інтелектуальною власністю або отримує дохід від її роздрібних продажів. Контрактна виручка та комерційний результат власного продукту належать до різних бізнес-моделей, тому їх варто оцінювати окремо.
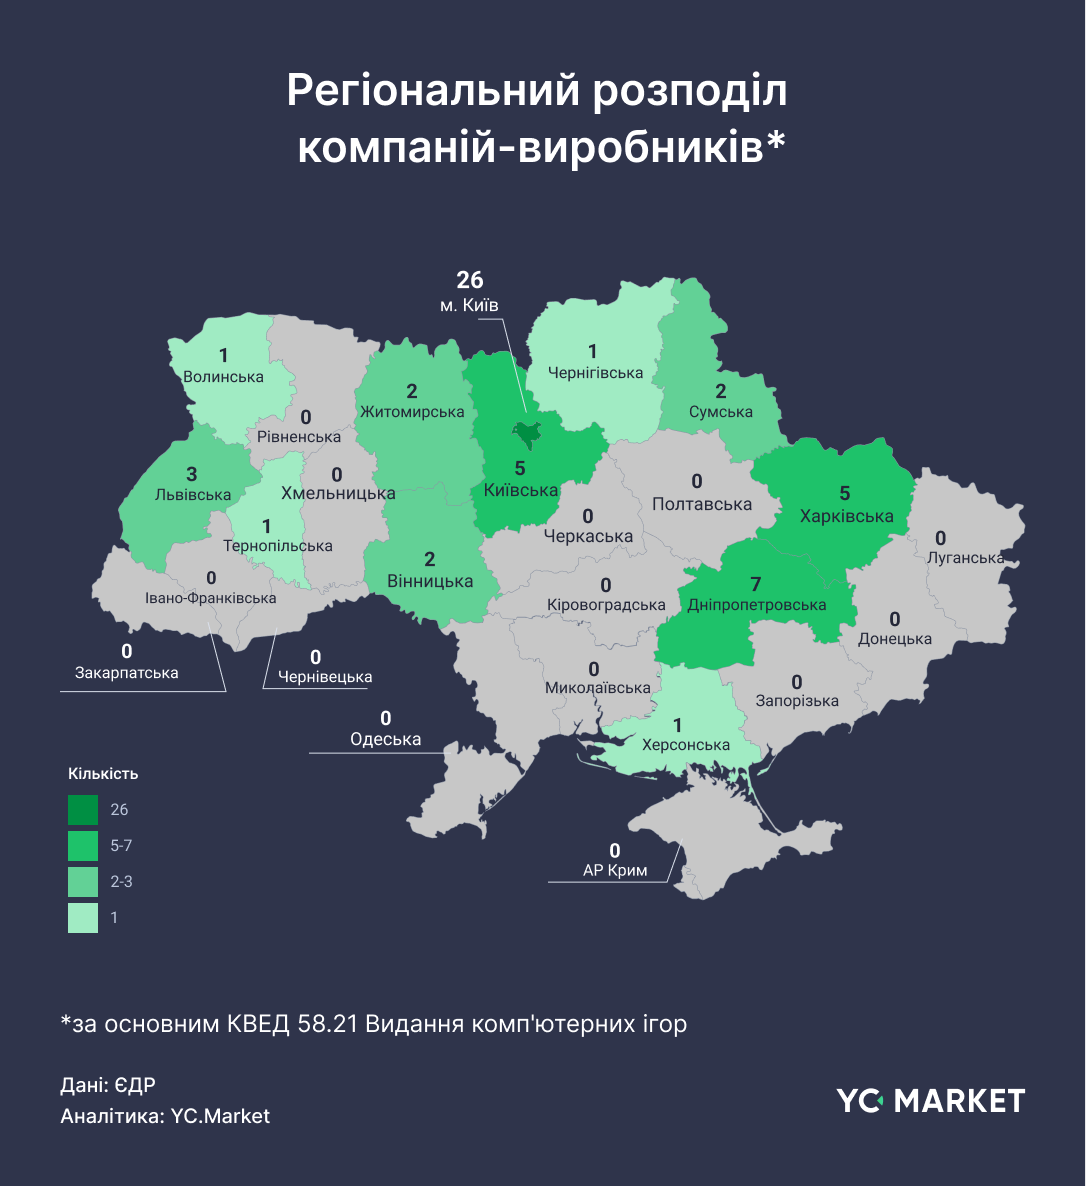
Географія компаній у дослідженні має виразну концентрацію. YC.Market сформував вибірку з 56 юридичних осіб, які подали фінансову звітність за 2025 рік і мають основний КВЕД 58.21. У Києві зареєстровано 26 із них, або 46%. Ще п’ять компаній працюють у Київській області. Разом столичний регіон охоплює понад 55% вибірки. Дніпропетровська область представлена сімома компаніями, Харківська п’ятьма, Львівська трьома.
Масштаб продуктової частини індустрії краще ілюструють проєкти, які не потрапили до рейтингу. S.T.A.L.K.E.R. 2: Heart of Chornobyl від GSC Game World вийшла 20 листопада 2024 року й розійшлася понад мільйоном копій за перші 48 годин, за даними, наведеними в дослідженні. Водночас студія працює за КВЕД 62.01, тому її результати не відображені в рейтингу видавців ігор.
Таким чином структура ринку наочно показує різницю між двома способами монетизації геймдев експертизи. Сервісний бізнес залежить від контрактного портфеля, відносин із видавцями та здатності забезпечувати потрібні компетенції. Продуктова модель потребує інвестицій у власну інтелектуальну власність і передбачає інший профіль комерційного ризику. Компанії, які поєднують обидва напрямки, можуть диверсифікувати джерела доходу, але мають розподіляти ресурси між клієнтськими проєктами та власною розробкою.
Тому для точнішої картини потрібні окремий аналіз сервісних і продуктових компаній, урахування різних КВЕДів та розуміння того, де саме формується дохід: у розробці на замовлення, видавничій діяльності чи продажу власних ігор.
12 октября 2026 г., 17:25
Штучний інтелект автоматизує пошук вразливостей, прискорює кібератаки та створює нові канали витоку корпоративних даних. Дослідження Akamai показує, чому компаніям доведеться переглянути захист API, браузерних розширень і автономних AI-агентів.
AI скорочує час, необхідний для пошуку вразливостей, автоматизує традиційні методи атак і розширює поверхню кіберзагроз. Водночас компанії продовжують усувати проблеми в темпі звичайних циклів розробки та оновлення програмного забезпечення. Цей дисбаланс між швидкістю атаки й реагуванням захисників став однією з головних проблем корпоративної кібербезпеки. Про це йдеться у звіті Akamai The Agentic Threat Landscape, присвяченому ризикам використання генеративного AI та автономних агентів.

За даними дослідження, у 2025 році обсяг трафіку AI-ботів зріс на 300%. Середня кількість щоденних атак на API в розрахунку на одну організацію збільшилася на 113%, до 258. А про інциденти, пов’язані з API, повідомили 87% опитаних компаній проти 76% у 2022 році. Ці показники свідчать про те, що інтерфейси програмування залишаються одним із головних напрямів атак, а поширення AI збільшує навантаження на системи, які забезпечують обмін даними між сервісами.
Зміни стосуються не лише кількості запитів. AI дає змогу автоматизувати розвідку, аналіз вразливостей і поєднання кількох етапів атаки. За оцінкою Akamai, пошук слабких місць, який раніше міг тривати тижнями, тепер у певних випадках займає години. Компанії не здатні так само швидко перевіряти всі знахідки, оцінювати їхній вплив і випускати виправлення. Тому першочерговим завданням стає визначення того, які вразливості доступні зловмисникам, чи можна їх експлуатувати та яких бізнес-процесів вони стосуються.
Звіт також звертає увагу на автономні AI-агенти, які не просто генерують відповіді, а виконують дії через API, звертаються до баз даних і взаємодіють із корпоративними системами. Одним із механізмів такої інтеграції є Model Context Protocol (MCP). Він дає моделям змогу підключати зовнішні інструменти, але водночас створює нові межі довіри, які потрібно контролювати.
Зловмисник може приховати інструкції в описі інструмента або зовнішньому вебконтенті, щоб змінити поведінку моделі. У складніших сценаріях скомпрометований сервер із низьким рівнем довіри може вплинути на агента так, щоб той звернувся до внутрішньої бази даних чи сховища ключів. Ризик полягає не лише в безпосередньому виконанні шкідливого коду, а й у тому, що модель може використати власні дозволи для дій, яких не планував користувач.
Akamai рекомендує ізолювати MCP-сервери відповідно до рівня довіри, перевіряти сторонній код, обмежувати мережеві з’єднання та контролювати обмін даними між компонентами. Для операцій, що змінюють стан систем або можуть спричинити значні наслідки, варто передбачити обов’язкове підтвердження людиною. Автономність агента має залежати не від його технічних можливостей, а від того, наскільки реально перевірити результат і виправити помилку.
Інший напрям ризику пов’язаний із браузером. За даними звіту, понад 40% корпоративних користувачів установили розширення з функціями AI. Водночас чверть установлених розширень змінювали дозволи протягом 12 місяців. Такі зміни можуть розширювати доступ до вкладок, вмісту сторінок і даних сеансів уже після встановлення. Якщо організація не має актуального переліку розширень та інформації про їхні дозволи, вона може не помітити, як робочий браузер перетворюється на канал витоку інформації або викрадення облікових даних.

Окрему проблему становить використання чатботів працівниками. Внутрішній аналіз Akamai показав, що 5,81% розмов з AI містили персональні дані, 0,96% стосувалися фінансової інформації, а 0,94% містили дані про ІТ та безпеку. Крім того, 47% розмов з AI на корпоративних пристроях відбувалися через особисті облікові записи. Через це служби безпеки можуть не бачити частину взаємодій, під час яких працівники передають зовнішнім сервісам внутрішню інформацію.
Таким чином контроль не можна обмежити затвердженням корпоративного чатбота. Потрібно виявляти несанкціоновані AI-сервіси, розуміти, до яких даних вони мають доступ, керувати браузерними розширеннями та перевіряти дозволи агентів. Для систем, інтегрованих із бізнес-процесами, необхідні інвентаризація API та AI-компонентів, моніторинг поведінки під час виконання, сегментація доступу й аудит дій.
Втім Akamai не пропонує створювати ізольовану програму безпеки виключно для AI. Натомість компаніям варто поширити на нові системи наявні практики управління ідентичностями, контролю доступу, захисту API, управління вразливостями та реагування на інциденти. Для ризикованих операцій потрібні додаткові обмеження й людський контроль, а для швидкого блокування атак до встановлення виправлень можуть застосовуватися захисні механізми на рівні мережевого периметра та середовища виконання.
AI не змінює основних цілей зловмисників, але прискорює пошук шляхів до них і здешевлює автоматизацію атак. Тому організаціям доведеться оцінювати не лише те, які моделі вони використовують, а й те, які повноваження отримують ці системи, до яких ресурсів можуть звертатися та наскільки швидко їхні дії можна виявити й зупинити.
1 октября 2026 г., 17:45
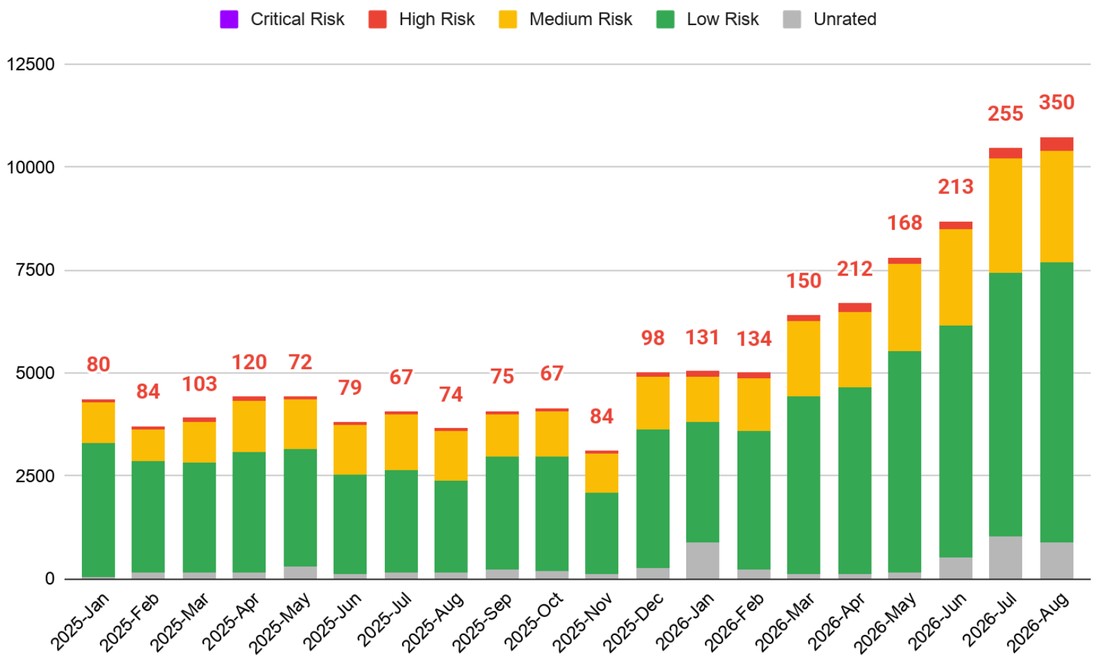
Стрімку трансформацію ландшафту кіберзагроз фіксує в останньому звіти Google Threat Intelligence Group (GTIG). Цього року щомісячна кількість публічних розкриттів вразливостей програмного забезпечення зросла більш ніж удвічі – з 5045 у січні до 10740 у серпні. Попри те, що загальна статистика дещо роздута автоматичною генерацією ідентифікаторів у середовищі open-source – близько 5000 записів стосувалися ядра Linux без жодного реального zero-day експлойту, показник високоризикових загроз за власною шкалою GTIG зріс на 167%. Головним каталізатором цієї динаміки стало масове залучення штучного інтелекту, який кардинально змінив як швидкість виявлення системних прогалин, так і характер їх подальшої експлуатації.
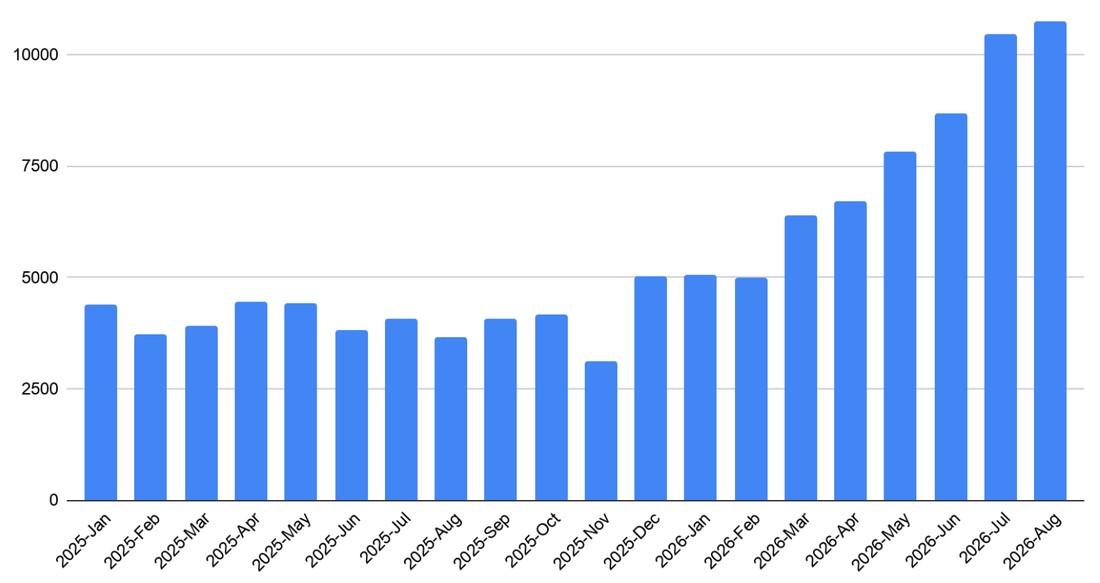
Аналітики підкреслюють, що зловмисники все активніше використовують великі мовні моделі (LLM) для автоматичного порівняння версій продуктів та патчів, що дозволяє їм миттєво перетворювати відомі публічні вразливості на діючі експлойти. Саме цим пояснюється сплеск атак на так звані N-day вразливості, коли удар завдається по системах, що не встигли оновитися після публікації патчу. Водночас кількість реальних експлуатацій у «дикій природі» за 8 місяців сягнула 141 випадку, перевищивши весь 2025 рік. При цьому середній показник нулевих днів (zero-days) зріс до 11 на місяць із піковим стрибком у серпні до 22 випадків, що свідчить про суттєве скорочення вікна реакції для IT-підрозділів бізнесу.
Окрему увагу в дослідженні приділено прогалинам, які знаходять самі AI-агенти. На відміну від традиційних сканерів та людських дослідників, штучний інтелект значно краще виявляє глибокі помилки роботи з пам'яттю та логічні обходи у коді на C та C++. У результаті половина виявлених AI-агентами вразливостей допускають віддалене виконання коду (Remote Code Execution), тоді як серед класичних розкриттів цей показник становить лише 26%. Показовим прикладом реальності цієї загрози стала вразливість CVE-2026-1731 у продуктах BeyondTrust, автономно знайдена дослідницьким агентом Hacktron AI. Вже за чотири дні після публікації її почала експлуатувати перша хакерська група, а за тиждень до них приєдналися ще п'ять угруповань для впровадження шкідливого софту та викрадення даних.
Не менш критичним вектором залишається безпека самих систем штучного інтелекту. З понад 2000 розкритих вразливостей в AI-софті з початку 2025 року, левова частка припадає саме на 2026 рік. Майже половина з них зафіксована у фреймворках оркестрації агентів, таких як Flowise та Langflow, де візуальні конструктори воркфлоу часто містять вузли виконання коду, вразливі до prompt-ін'єкцій. Окрім цього, понад 200 вразливостей знайдено в інструментах інференсу (vLLM, Ollama, LiteLLM), де основними ризиками є незахищені кінцеві точки API та підробка міжсерверних запитів (SSRF). Хоча zero-days атак безпосередньо на AI-інфраструктуру ще не зафіксовано, липневий випадок автономного вимагацького софту через вразливість у Langflow демонструє, що ця інфраструктура вже під прицілом.
У підсумку звіту фахівці Google закликають організації відмовитися від суцільного масового патчингу «наосліп» на користь приорітизації на основі аналізу загроз (Threat Intelligence) та посилення периметра. Розробникам програмного забезпечення рекомендується інтегрувати агентні AI-інструменти перевірки коду безпосередньо у процес розробки до релізу продукту, що в перспективі дозволить суттєво уповільнити зростання публічних вразливостей.
14 сентября 2026 г., 17:25
Сучасні цифрові амбіції зіткнулася з жорсткою стелею фізичної інфраструктури. Поки бізнес-стратеги малюють картини тотальної автоматизації, фундамент, на якому тримається весь цей масив даних, демонструє ознаки критичної втоми.
Дослідження, проведене за ініціативи Lenovo, виявляє тривожну ситуацію: майже половина ІТ-лідерів (45%) відверто визнають, що їхні нинішні потужності не здатні підтримати навіть базові цілі зі сталого розвитку. Апетит AI-алгоритмів до обчислень зростає експоненціально, а методи охолодження та живлення інфраструктури залишаються на рівні вчорашнього дня. Традиційне повітряне охолодження стає архаїзмом, адже воно не здатне балансувати між вартістю, ефективністю та дедалі суворішими екологічними вимогами.
Проблема сталого розвитку – це питання операційної спроможності. Понад 90% керівників сьогодні шукають партнерів, які пропонують компенсацію вуглецевого сліду та енергоефективні інновації, але реальність така, що лише 46% мають дизайн ЦОД, який хоча б теоретично відповідає цим цілям. Штучний інтелект став одночасно і головним драйвером зростання, і основним болем для архітекторів: 90% опитаних впевнені, що АІ радикально збільшить обсяги даних у найближче десятиліття, проте 41% визнають свою повну неготовність до його ефективної інтеграції. Це створює небезпечний вакуум між «цифровим бажанням» і «інфраструктурною дійсністю», де кожне нове впровадження моделі стає стрес-тестом для енергосистеми.
Паралельно з енергетичним викликом постає питання цифрового суверенітету, яке для 99% управлінців у регіоні EMEA стало критичним фактором на найближчі роки. Контроль за тим, де саме фізично перебувають дані, тепер визначає дизайн майбутніх об’єктів. Додайте до цього вимогу низької затримки (latency), про яку говорять 94% респондентів, і ви отримаєте надскладне завдання: дата-центри мають бути ближче до споживача, інтегровані в міський ландшафт, але водночас відповідати жорстким правилам безпеки та суверенітету.
Візія дата-центру зразка 2055 року, розроблена спільно інженерами AKT II та архітекторами Mamou-Mani, пропонує вихід за межі звичних серверних у бетонних коробках. Йдеться про радикальну зміну підходу – робити ЦОД не більшими, а кращими. Концепція Floating Cloud передбачає винесення модулів на висоту 20-30 км, де вони отримуватимуть енергію від сонця 24/7 та охолоджуватимуться в закритих рідинних контурах під тиском, не забруднюючи повітря. Інший підхід – Data Village, де модульні системи розташовуються поблизу річок чи каналів для ефективного рідинного охолодження, а відпрацьоване тепло серверів передається на потреби громад: для обігріву приватних будинків у форматі Data Spa. Навіть закинуті бункери та тунелі транспортних систем можуть стати новими домівками для даних, використовуючи природні властивості підземного середовища для терморегуляції та підвищення фізичної безпеки.
Спільним знаменником для всіх цих концепцій є перехід на рідинне охолодження. Сучасні технології вже сьогодні дозволяють відводити до 98% тепла безпосередньо від джерела всередині стійки, що робить інфраструктуру готовою до AI-масштабування без ризику термічного колапсу. Майбутнє обчислювальних потужностей – це не просто закупівля нового «заліза», а зміна парадигми, де сталий розвиток є невіддільною частиною архітектури системи. Адже справжня підготовка до майбутнього починається не з планів на десятиліття, а з відповідних технологічних рішень.
31 августа 2026 г., 17:25
Масове впровадження генеративних моделей породжує проблему «meat proxy» – працівників, які бездумно пересилають колегам згенерований штучним інтелектом текст або код без перевірки, редагування власного аналізу чи адаптації. Таким чином людина фактично виступає зайвим посередником між двома сторонами та не створює геть ніякої цінності. Адресату простіше самостійно звернутися до тієї самої моделі, задати власний контекст і швидше отримати потрібний результат.
Термін «м'ясне проксі» з'явився серед розробників як іронічна характеристика співробітників, які виконують роль пасивного ретранслятора між LLM та колегами. Замість того щоб самостійно проаналізувати завдання, сформулювати рішення чи хоча б перевірити згенерований фрагмент, людина просто копіює запит у чат-бот, а отриманий результат без змін надсилає в робочі канали. Термін швидко набув популярності, оскільки описана поведінка перестала бути поодиноким випадком і перетворилася на системний маркер внутрішніх процесів.
Теоретично, залучення AI має підвищувати продуктивність роботи. Проте формальна трансляція відповідей створює зворотний ефект і навпаки спричиняє приховані витрати. Коли розробник надсилає сирий код колезі або технічному керівнику, він не економить час компанії, а лише перекладає когнітивне навантаження на іншу людину. Замість швидкої перевірки готової концепції рецензент змушений виконувати роботу первинного аналітика, шукати галюцинації моделі, виправляти приховані баги та перевіряти логічні зв'язки.
Поширення такої практики є симптомом управлінських проблем. Воно вказує на зміщення фокуса з якості результату на швидкість закриття задач у трекерах. Коли оцінка продуктивності базується виключно на кількості закритих тікетів або написаних рядків, працівники обирають найменш енерговитратний шлях. В результаті формується культура, у якій зникає персональна відповідальність за фінальний продукт.
Наслідки використання працівників як проксі між алгоритмом та виробничою системою виходять далеко за межі роздратування у внутрішніх чатах. Знижується загальний рівень експертизи в команді. Молодші спеціалісти, які замість вивчення баз даних та архітектурних шаблонів просто ретранслюють підказки моделі, втрачають можливість сформувати базові інженерні навички. Зростає ризик потрапляння у продакшн критичних вразливостей, адже штучний інтелект часто створює синтаксично коректний, але логічно хибний чи небезпечний код.
Крім того, деградує внутрішня комунікація. Контекст, який людина мала б пропускати через власний досвід та розуміння бізнес-цілей, замінюється стандартними формалізованими абзацами від великих мовних моделей. Робочі обговорення перетворюються на обмін згенерованим шумом (так званий AI slop), де жодна зі сторін повністю не розуміє суті предмета.
Втім розв'язання цієї проблеми лежить не в забороні AI-інструментів, а в зміні стандартів рецензування та оцінки роботи. Варто впроваджувати чіткі регламенти. Наявність згенерованого фрагмента має супроводжуватися обов'язковим підтвердженням того, що автор запиту розуміє кожний рядок запропонованого рішення. Фінальний код чи документ повинен залишатися відповідальністю людини, а не системи. Інженер або виконавець має виступати фільтром та архітектором, а не бездумним проксі.
14 августа 2026 г., 17:25
Опитування Salesforce, у якому взяли участь понад 500 менеджерів, показало, що поширення штучного інтелекту не зменшує значення середньої ланки управління, а навпаки підвищує її роль у цифровій трансформації компаній. Більшість керівників уже використовують AI у повсякденній роботі та відзначають зростання продуктивності, однак водночас саме вони дедалі частіше відповідають за впровадження нових технологій у командах без достатніх інструментів для оцінки результатів і організаційної підтримки.

Дві третини опитаних менеджерів позитивно оцінюють вплив AI на майбутнє роботи, а 77% повідомили, що завдяки AI-інструментам економлять понад три години на тиждень. Крім того, 73% вважають, що вже здатні оцінювати, які завдання доцільно делегувати системам штучного інтелекту. Найпоширенішим сценарієм використання AI став аналіз даних, що свідчить про його інтеграцію в процеси ухвалення управлінських рішень. Далі за популярністю йдуть дослідницькі завдання та креативні проєкти. Водночас Salesforce посилається на окреме дослідження Beautiful.ai, за даними якого у 2025 році AI використовували 77% американських менеджерів, що на 11 пунктів більше, ніж роком раніше.
Разом із поширенням AI змінюється і відповідальність менеджерів. 78% респондентів вважають, що саме вони відповідають за успішне впровадження штучного інтелекту у своїх командах. Майже половина відчувають тиск із боку вищого керівництва, яке очікує помітних результатів від використання AI. Водночас лише 32% працюють в організаціях, де існують формалізовані механізми відстеження використання таких технологій. Фактично менеджери мають демонструвати результати цифрової трансформації, не завжди маючи єдині критерії оцінки її ефективності.
Дослідження також показує, що впровадження AI супроводжується новими викликами для самих керівників. Понад половина опитаних, 51%, відчувають тривожність через необхідність постійно опановувати нові AI-інструменти, щоб відповідати очікуванням керівництва та власних команд. При цьому 44% менеджерів середньої ланки називають організаційну бюрократію головною причиною негативного досвіду у своїй ролі. Саме адміністративне навантаження визначається як один із головних чинників, що обмежує можливість менеджерів зосередитися на розвитку команд, наставництві та реалізації бізнес-стратегії.

Майже половина опитаних, 48%, очікують суттєвих або фундаментальних змін власної ролі вже протягом найближчих двох-трьох років. На думку Salesforce, AI поступово перебирає на себе рутинні адміністративні функції, тоді як менеджери дедалі більше зосереджуватимуться на координації роботи команд, розвитку співробітників, ухваленні стратегічних рішень та управлінні змінами. У документі також зазначається, що AI може допомагати виявляти прогалини в компетенціях, формувати персоналізовані рекомендації щодо навчання та надавати керівникам оперативні аналітичні дані для управління командами.
Найчастіше менеджери потребують практичного навчання роботи з AI (37%), наявності зрозумілої корпоративної стратегії використання штучного інтелекту (35%) та технічної підтримки з боку ІТ-підрозділів (34%). Тож наступний етап розвитку AI у корпоративному середовищі пов'язаний не лише з автоматизацією окремих процесів, а й зі зміною ролі менеджерів, які стають ключовою ланкою між стратегією компанії та практичним впровадженням нових технологій. У Salesforce вважають, що ефективність цієї трансформації залежатиме від того, наскільки компанії зможуть скоротити адміністративне навантаження на менеджерів і надати їм інструменти для управління змінами та розвитку команд.
24 июля 2026 г., 17:55
Корпоративні AI-агенти переходять із розряду експериментів у повсякденний інструмент бізнесу, але політики безпеки не встигають за їхнім поширенням. Опитування понад 1500 фахівців з ІТ- та кібербезпеки показує, що головною проблемою стають уже не самі великі мовні моделі, а автономні AI-системи з доступом до корпоративних даних і бізнес-процесів.

Якщо ще рік тому основна увага служб інформаційної безпеки була прикута до ChatGPT, Microsoft Copilot та інших генеративних моделей, то у 2026 році центр ризиків зміщується. Тепер найбільше занепокоєння викликають AI-агенти, які не лише генерують текст, а й можуть самостійно взаємодіяти з корпоративними системами, виконувати бізнес-процеси, працювати з внутрішніми даними та приймати рішення в межах наданих повноважень.
Саме це є головним висновком дослідження State of AI Cybersecurity 2026, підготовленого Darktrace на основі опитування понад 1500 керівників і фахівців із кібербезпеки в різних країнах. 92% респондентів заявили, що стурбовані впливом AI-агентів на безпеку організацій. Для порівняння, щодо сторонніх великих мовних моделей високий рівень занепокоєння висловили лише 44% опитаних.
Причина зміни пріоритетів полягає у характері самих AI-агентів. Якщо генеративна модель здебільшого відповідає на запити користувача, то агент здатний отримувати доступ до корпоративних застосунків, виконувати послідовність дій, взаємодіяти з іншими сервісами та автоматизувати робочі процеси. Відповідно, компрометація такого інструмента або його некоректне налаштування створює зовсім інший масштаб ризиків, ніж звичайний чат-бот.
Результати дослідження показують, що впровадження AI у компаніях відбувається швидше, ніж розвиток механізмів управління його безпекою. Darktrace зазначає, що генеративний AI та агентні системи вже стали частиною повсякденних робочих процесів, а традиційні підходи до інформаційної безпеки не розраховані на контроль автономних систем, які можуть працювати з конфіденційними даними або виконувати дії від імені користувачів.
Ще одна тенденція полягає в тому, що AI одночасно ускладнює роботу захисників і стає одним із головних інструментів захисту. За даними дослідження, 87% респондентів вважають, що AI збільшує кількість або складність кіберзагроз, які доводиться обробляти службам безпеки. Одночасно 96% погоджуються, що використання AI покращує можливості захисту, насамперед завдяки швидшому аналізу інцидентів, автоматизації рутинних операцій та ефективнішому виявленню нових атак.

AI вже став звичайною складовою корпоративних засобів кіберзахисту. Генеративні моделі використовуються у 77% стеків інформаційної безпеки, причому дедалі частіше поряд із класичним машинним навчанням застосовуються агентні системи. Водночас автори дослідження звертають увагу, що рівень довіри до таких рішень поки що не відповідає темпам їхнього впровадження. Багато організацій ще не мають достатнього досвіду оцінювання того, які саме функції доцільно автоматизувати, а де необхідно залишати контроль за людиною.
Якщо раніше політики безпеки були орієнтовані переважно на користувачів, сервери та застосунки, то тепер окремим об'єктом контролю стають AI-системи. Постає необхідність відстежувати, які агенти працюють в організації, до яких даних вони мають доступ, які дії можуть виконувати автоматично та як контролюється їхня поведінка.
Чим більше автономних AI-агентів інтегрується у внутрішні процеси, тим важливішими стають інвентаризація таких систем, аудит їхніх повноважень і постійний моніторинг їхньої активності. Саме ці питання, а не лише захист великих мовних моделей, дедалі більше визначають порядок денний корпоративної кібербезпеки. Таким чином наразі головний виклик полягає вже не у використанні AI як інструмента, а в безпечному управлінні автономними AI-системами, що дедалі глибше інтегруються в бізнес-процеси.
14 июля 2026 г., 17:30
Працівники давно використовують генеративний штучний інтелект поза корпоративними політиками, але головна проблема полягає не в самому факті тіньового AI. Дослідження Teramind, яка знається на управлінні інсайдерськими ризиками та запобіганні витоку даних, показує, що традиційні механізми контролю майже не бачать, які дані потрапляють до AI-сервісів, а спроби їх блокувати лише переводять активність у ще менш контрольовані канали.

Дискусія навколо тіньового AI зазвичай зводиться до того, що співробітники користуються несанкціонованими сервісами на кшталт ChatGPT чи Gemini. Але звіт Teramind, дистриб'ютором якої в нашій країні є Softprom, показує іншу проблему. Для корпоративної безпеки головним викликом стала втрата видимості над тим, як корпоративні дані потрапляють до цих сервісів і повертаються назад у бізнес-процеси. Саме цей розрив між реальною поведінкою користувачів і можливостями ІТ-підрозділів автори вважають визначальною характеристикою сучасного тіньового AI.
За даними дослідження, офіційні корпоративні підписки на великі мовні моделі вже мають 98% компаній. Водночас у 90% організацій співробітники паралельно використовують несанкціоновані AI-інструменти. На кожну тисячу працівників припадає в середньому 269 різних AI-сервісів, а в типовій організації виявляють близько 66 генеративних застосунків, частина яких має високий рівень ризику. При цьому більшість таких сервісів залишаються активними понад 400 днів після першого використання, тобто мова вже давно не про експерименти окремих співробітників, а про інструменти, які стали частиною повсякденних робочих процесів.
Основна причина ризиків полягає в тому, що корпоративні дані регулярно потрапляють до зовнішніх AI-систем. Дослідники фіксують стрімке зростання інцидентів DLP, пов'язаних із генеративним AI, а серед інформації, яку працівники надсилають до сторонніх сервісів, є клієнтські дані, вихідний код, матеріали досліджень, внутрішні документи, HR-інформація та фінансові файли. Окремо зазначається, що третина користувачів несанкціонованих AI-сервісів уже передавала через них дослідницькі матеріали або набори даних, понад чверть – інформацію про співробітників, а майже чверть – фінансові дані компаній.
Найцікавіший висновок стосується не файлів чи API, а звичайного копіювання тексту. Саме copy-paste, а не завантаження документів, дослідники називають основним каналом потрапляння корпоративної інформації до Gen AI. У середньому співробітник вставляє інформацію до AI-сервісів 14 разів на день, причому три такі операції містять чутливі дані. Для більшості традиційних DLP-систем саме така поведінка залишається найменш помітною.

До того ж дослідження показує, що блокування окремих AI-сервісів не припиняє використання генеративного AI. Працівники просто переходять на інші сервіси, використовують особисті пристрої або ще якось обходять обмеження. Майже половина респондентів заявила, що продовжить користуватися AI навіть після прямої заборони, а дві третини співробітників знаходять способи отримати доступ до заблокованих застосунків. Автори роблять висновок, що стратегія, побудована виключно на заборонах, фактично переводить тіньовий AI у ще менш контрольоване середовище.
Показовою є також проблема корпоративної ідентифікації. Більшість користувачів працює з генеративним AI через особисті акаунти, а не через корпоративні облікові записи із SSO. Через це інструменти контролю доступу, політики збереження даних і системи аудиту просто не бачать значної частини взаємодії співробітників з AI-платформами. Водночас 86% організацій визнають, що не мають достатньої видимості потоків даних до AI-сервісів, а 60% ІТ-команд не можуть навіть переглянути запити, які користувачі надсилають генеративним моделям.
Звіт також звертає увагу на ще одну тенденцію. Ризики виникають не лише тоді, коли дані потрапляють до генеративного AI, а й коли створений ним контент повертається у корпоративні процеси. AI-відповіді дедалі частіше використовують у документації, програмному коді, юридичних документах, матеріалах для клієнтів та інших робочих процесах. Якщо такий контент потрапляє до регульованих сфер без перевірки, відповідальність за його точність і відповідність нормативним вимогам несе вже сама організація незалежно від того, що його створила мовна модель.
Таким чином масштаб тіньового AI вже неможливо зменшити лише політиками чи навчанням персоналу. Організаціям доведеться поєднувати контроль за потоками даних, інвентаризацію AI-сервісів, корпоративні альтернативи популярним генеративним інструментам і політики, які враховують реальну поведінку користувачів, а не припущення про те, як вони повинні працювати. При цьому самі автори наголошують, що будь-які механізми моніторингу мають впроваджуватися з урахуванням вимог трудового законодавства, захисту персональних даних і локальних регуляторних норм.
2 июля 2026 г., 17:25
Дослідження GitLab та компанії Harris Poll виявило зміщення фокусу в розробці програмного забезпечення з генерації коду на його аудит і контроль. Керівники стикаються з накопиченням структурних недоліків коду, а його всебічна перевірка стає головним вузьким місцем.
Впровадження штучного інтелекту в процеси створення програмного забезпечення перейшло зі стадії експериментів у категорію базової інфраструктури. Згідно з глобальним дослідженням компанії GitLab та Harris Poll, проведеним серед більш ніж півтори тисячі фахівців з DevSecOps, 91% організацій уже використовують у промисловому середовищі два або більше інструментів генерації коду одночасно. Понад половина компаній інтегрували три або більше подібних систем. Економічний ефект від цих інвестицій виявився помітним, адже 60% опитаних зазначають, що окупність вкладень перевищила їхні початкові очікування, а 78% фіксують прискорення написання та фіксації коду окремими розробниками.

Проте масове прискорення роботи на рівні клавіатури виявило глибокі структурні проблеми на наступних етапах життєвого циклу продукту. Безпосереднє написання коду сьогодні займає лише 16% робочого часу на його створення. Справжні затримки тепер виникають нижче за течією, під час рецензування, тестування, забезпечення безпеки, аудиту відповідності та розгортання. 79% опитаних керівників визнають, що продуктивність окремих розробників зросла, але загальний процес доставки програмного забезпечення практично не прискорився. 85% респондентів констатують зміщення головного вузького місця з написання коду на його перевірку та валідацію. Швидкість штучного інтелекту зупиняється там, де починаються процеси безпеки та комплаєнсу, змушуючи весь життєвий цикл чекати ручних рішень.
Паралельно зростає занепокоєння щодо довгострокової підтримки кодових баз. 82% фахівців вважають, що автоматично згенерований код створює новий різновид технічного боргу, до управління яким більшість організацій наразі просто не готові. 73% опитаних висловлюють серйозні побоювання щодо довгострокової сумісності та підтримуваності таких систем. За відсутності прозорих правил гри штучний інтелект здатний накопичувати структурні дефекти значно швидше, ніж традиційні методи розробки, про що заявляють 86% опитаних. Це створює міну уповільненої дії для майбутньої архітектури підприємства.

Найбільш показовим виявився розрив між упевненістю менеджменту та реальними технічними можливостями під час ліквідації аварій. 87% опитаних вважають, що їхні команди здатні протягом доби визначити, чи став штучний інтелект причиною збою у промисловому середовищі. Водночас аналіз реальних інцидентів за останній рік демонструє зовсім іншу картину. Третина організацій, які зіткнулися із серйозними аваріями чи порушеннями безпеки, не змогли зробити остаточний висновок щодо участі автоматично згенерованого коду у збої. Причиною такої вразливості є фрагментація інструментів. 43% респондентів скаржаться на складність розрізнення коду, написаного людиною та машиною, а 40% вказують на розірваність ланцюжка інструментів, які не обмінюються контекстом. Лише 28% компаній мають повністю інтегровані системи розробки з єдиною моделлю даних.
Таким чином управління та підзвітність стають пріоритетом на найближчу перспективу. Хоча три чверті організацій уже впровадили певні формальні політики чи інструкції, 80% менеджерів визнають, що технології впроваджувалися набагато швидше, ніж створювалися правила регулювання. Ключовими викликами залишаються атрибуція коду, тобто розуміння того, яка саме система його створила, та відстеження зв'язку коду з початковими бізнес-вимогами. Через це 85% фахівців згодні, що наступна фаза використання штучного інтелекту буде зосереджена не на генерації нового обсягу коду, а на забезпеченні контролю за ним. Тому 91% опитаних планують інвестиції у спеціалізовані інструменти управління, а понад половина вже розпочали оцінювання конкретних технологічних рішень.
|
|
|

